


Perché il nuovo watermark digitale di OpenAI non vi impedirà di essere ingannati
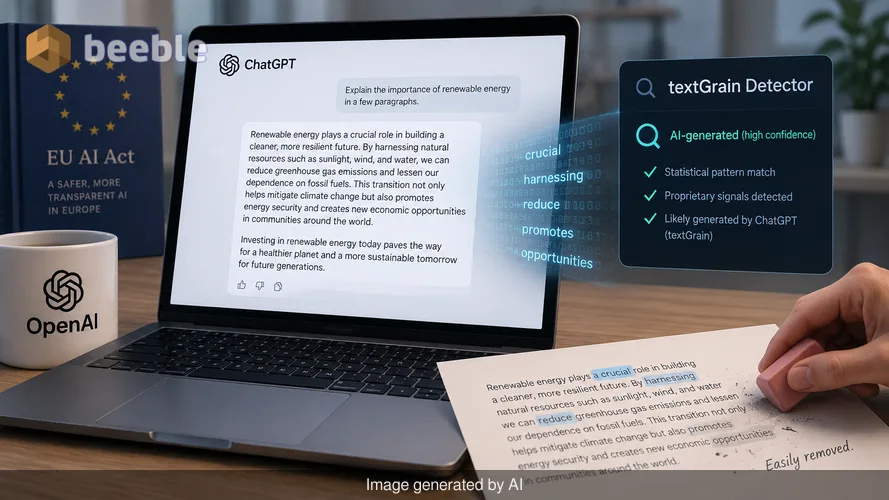
Mentre il mondo richiede chiarezza su cosa sia umano e cosa sia macchina, OpenAI ha appena lanciato uno strumento che promette trasparenza ma offre qualcosa di molto più fragile. La società ha recentemente annunciato che ChatGPT applicherà ora un watermark ai suoi output testuali per impostazione predefinita per gli utenti nell'Unione Europea. Questo cambiamento segue i requisiti dell'EU AI Act, che impone che i contenuti generati dall'IA debbano essere rilevabili. Tuttavia, la realtà sotto il cofano suggerisce che questo nuovo sigillo digitale assomigli meno a un marchio permanente e più a un leggero segno di matita che un bambino potrebbe cancellare con un solo colpo.
OpenAI chiama il suo nuovo metodo textGrain. In termini semplici, si tratta di un sistema proprietario che incorpora modelli statistici nelle parole scelte dall'IA. Per l'utente medio, il testo appare identico a qualsiasi altra risposta. La grammatica è corretta, il tono è coerente e le informazioni sono le stesse. Ma per uno strumento di rilevamento specializzato, quelle scelte di parole fungono da impronta digitale. Questo sistema opera come un instancabile stagista a cui è stato detto di usare un set specifico di sinonimi ogni volta che scrive un promemoria. Se conosci il modello, puoi identificare lo stagista. Se non conosci il modello, il promemoria sembra perfettamente standard.
La fragilità dei modelli invisibili
Guardando al quadro generale, l'efficacia di textGrain dipende interamente dal fatto che il testo rimanga intatto. I dati stessi di OpenAI rivelano una vulnerabilità sorprendente che la maggior parte dei comunicati stampa aziendali preferirebbe sorvolare. In condizioni ideali, lo strumento ha una percentuale di successo del 92% nell'identificare la propria scrittura. Questo sembra impressionante finché non si applica la minima quantità di sforzo umano.
Cambiare solo il 10% del testo generato fa crollare il tasso di rilevamento di quasi il 30%. Se un utente scambia il 20% delle parole — magari cambiando alcuni aggettivi o riformulando un paio di frasi — il tasso di successo cala di quasi il 75%. In termini pratici, chiunque abbia una conoscenza di base di un dizionario dei sinonimi può bypassare questo sistema in pochi secondi. Ciò rende il watermark uno strumento di conformità per i regolatori piuttosto che una rete di sicurezza affidabile per il pubblico. Soddisfa la lettera della legge nell'UE senza risolvere effettivamente il problema generale dell'inganno dell'IA.
Una storia di due strategie aziendali
Sul lato del mercato, il contrasto tra OpenAI e il suo principale concorrente, Anthropic, è netto. Anthropic ha introdotto il proprio sistema di watermarking all'inizio di quest'anno, ma ha scelto di abilitarlo per tutti gli utenti a livello globale. OpenAI ha intrapreso un percorso più selettivo, attivando la funzione per impostazione predefinita solo dove la legge lo richiede. Gli utenti negli Stati Uniti, in Asia e in altre regioni avranno ancora output "puliti" a meno che loro o le loro organizzazioni non scelgano manualmente di aderire tramite un'API.
Questa divisione regionale crea un ambiente digitale frammentato. Uno studente a Berlino riceverà saggi con watermark per impostazione predefinita, mentre uno studente a New York no. Dal punto di vista del consumatore, ciò suggerisce che OpenAI consideri il watermarking come un ostacolo normativo da superare piuttosto che come una caratteristica fondamentale di un prodotto affidabile. L'azienda sta facendo il minimo indispensabile per rimanere legale nell'UE, mantenendo il suo prodotto il più fluido possibile altrove.
| Caratteristica | OpenAI textGrain | Anthropic Watermarking |
|---|---|---|
| Regione Predefinita | Solo UE | Globale |
| Tasso di Rilevamento | 92% (Ideale) | Alto (Proprietario) |
| Sensibilità all'Editing | Alta (il 20% di modifiche lo rompe) | Da Moderata ad Alta |
| Accesso | Ricercatori Limitati | Pubblico/API |
| Standard | Proprietario | Proprietario/C2PA |
L'ostacolo tecnico tra testo e immagini
Sotto il cofano, applicare un watermark al testo è significativamente più difficile che farlo su immagini o video. Quando un sistema come DALL-E o Midjourney crea un'immagine, può nascondere metadati nei pixel o regolare i modelli di rumore in modo che rimangano invisibili all'occhio ma ovvi per un computer. Questi pixel sono densi e offrono migliaia di posti dove nascondere un segnale.
Il testo è diverso perché è rado. Una frase ha solo un certo numero di parole e ogni parola ha un numero limitato di sinonimi che abbiano senso nel contesto. Se l'IA forza una specifica scelta di parole per mantenere il watermark, rischia di rendere la scrittura goffa o ripetitiva. OpenAI afferma che textGrain non abbassa la qualità, ma il compromesso statistico è sempre presente. Per mantenere il watermark rilevabile, l'IA deve sacrificare una piccola parte della sua casualità creativa. Questo è il motivo per cui il tasso di rilevamento è ancora più basso per messaggi brevi o testi tradotti. Semplicemente non ci sono abbastanza dati in un'e-mail di tre frasi per nascondere un'impronta matematica complessa.
Cosa significa per la tua vita digitale
Per l'utente comune, l'arrivo di textGrain dovrebbe essere accolto con sano scetticismo. Se sei un insegnante, un editore o un responsabile delle assunzioni, non puoi fare affidamento su questi rilevatori per fornire una risposta definitiva. Il sistema è troppo facile da manipolare. Un utente può prendere un output di ChatGPT, passarlo attraverso un'IA diversa e senza watermark per una rapida riscrittura, e il watermark originale svanirà.
In definitiva, questo è un cambiamento sistemico nel modo in cui consideriamo la prova digitale. Ci stiamo allontanando da un mondo in cui possiamo fidarci di ciò che vediamo e verso un mondo in cui abbiamo bisogno di una "chiave" per verificare l'autenticità. OpenAI sta attualmente tenendo quella chiave dietro un cordone di velluto, concedendo l'accesso solo a un numero limitato di ricercatori e organizzazioni. Questa opacità crea un nuovo tipo di squilibrio di potere. L'azienda che crea il contenuto è anche l'unica che può rilevarlo in modo affidabile, e anche in quel caso, può farlo solo se l'utente è pigro.
Navigare in un mondo con watermark
In termini pratici, il lancio di textGrain nell'UE è un beta test per un futuro in cui tutto il lavoro digitale sarà etichettato. Serve come promemoria del fatto che gli strumenti che utilizziamo sono sempre più soggetti alla spina dorsale invisibile del diritto internazionale. Sebbene l'EU AI Act miri a proteggere i cittadini dall'essere tratti in inganno da deepfake e propaganda automatizzata, gli strumenti tecnici disponibili non sono ancora abbastanza resilienti per raggiungere tale obiettivo.
I consumatori dovrebbero osservare le proprie abitudini man mano che queste funzioni vengono distribuite. Potreste notare sottili cambiamenti nel modo in cui ChatGPT formula le sue risposte mentre il modello cerca di mantenere la sua impronta statistica. Potreste anche vedere un aumento degli strumenti "AI-cleaner", semplici programmi progettati specificamente per riscrivere il testo quel tanto che basta per eliminare questi marcatori. Il gioco del gatto e del topo tra i laboratori di IA e gli utenti sta entrando in una fase nuova e più localizzata.
Mentre andiamo avanti, smettete di cercare un distintivo o un timbro che dica "Creato dall'IA". Questi marcatori stanno diventando parte del petrolio greggio digitale che alimenta le nostre app, nascosti nel profondo della matematica delle frasi che leggiamo. Il punto fondamentale è che nessun watermark può sostituire il pensiero critico. Che un paragrafo abbia una grana statistica nascosta o meno, la responsabilità di verificare i fatti e l'intento spetta ancora al lettore. Lo stagista digitale sta ora etichettando il suo lavoro, ma spetta ancora al capo controllare se il lavoro è effettivamente corretto.
Fonti:
- OpenAI Technical Paper on textGrain and Statistical Watermarking
- European Commission: EU AI Act Regulatory Framework
- Anthropic Official Blog: Global Deployment of AI Content Marking
- C2PA (Coalition for Content Provenance and Authenticity) Standard Documentation



Ci vediamo dall'altra parte.
La nostra soluzione di archiviazione e-mail crittografata end-to-end fornisce i mezzi più potenti per lo scambio sicuro dei dati, garantendo la sicurezza e la privacy dei tuoi dati.
/ Creare un account gratuito
