


Почему новый цифровой водяной знак OpenAI не защитит вас от обмана
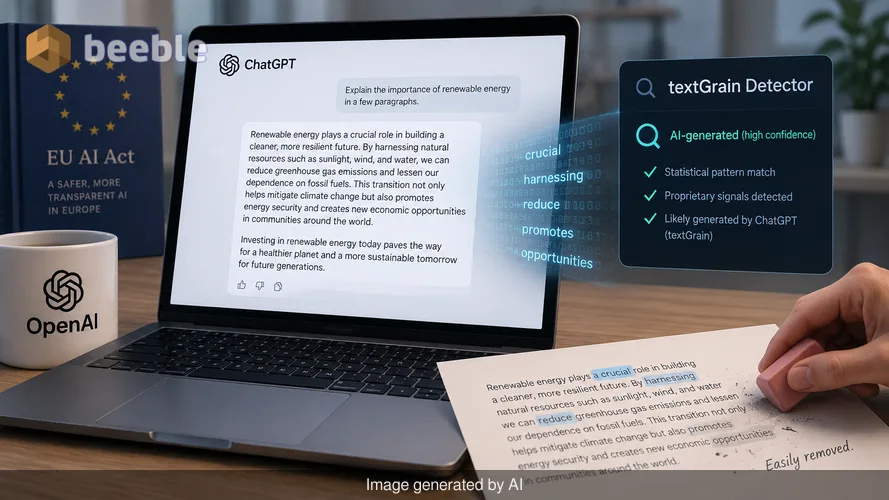
Пока мир требует ясности в том, что создано человеком, а что — машиной, компания OpenAI запустила инструмент, который обещает прозрачность, но на деле оказывается весьма хрупким решением. Недавно компания объявила, что ChatGPT теперь будет по умолчанию помечать свои текстовые ответы водяными знаками для пользователей в Европейском союзе. Это изменение продиктовано требованиями Закона ЕС об искусственном интеллекте (EU AI Act), который обязывает делать контент, созданный ИИ, распознаваемым. Однако реальное положение дел указывает на то, что эта новая «цифровая печать» больше похожа не на несмываемое клеймо, а на легкий след карандаша, который ребенок может стереть одним движением.
OpenAI называет свой новый метод textGrain. Проще говоря, это проприетарная система, которая встраивает статистические закономерности в слова, выбираемые ИИ. Для обычного пользователя текст выглядит идентично любому другому ответу. Грамматика в порядке, тон выдержан, информация та же. Но для специализированного детектора этот выбор слов служит «отпечатком пальца». Система работает как неутомимый стажер, которому поручили использовать определенный набор синонимов при написании каждой служебной записки. Если вы знаете закономерность, вы узнаете стажера. Если нет — записка выглядит совершенно стандартно.
Хрупкость невидимых паттернов
Если смотреть на картину в целом, эффективность textGrain полностью зависит от того, останется ли текст нетронутым. Собственные данные OpenAI выявляют поразительную уязвимость, которую большинство корпоративных пресс-релизов предпочли бы замолчать. В идеальных условиях инструмент имеет 92-процентный успех в идентификации собственного текста. Это звучит впечатляюще, пока вы не приложите минимальные человеческие усилия.
Изменение всего 10 процентов сгенерированного текста приводит к падению скорости обнаружения почти на 30 процентов. Если пользователь заменит 20 процентов слов — например, поменяв несколько прилагательных или перефразировав пару предложений — вероятность успеха падает почти на 75 процентов. На практике любой, кто умеет пользоваться словарем синонимов, может обойти эту систему за считанные секунды. Это делает водяной знак скорее инструментом соблюдения требований для регуляторов, чем надежной сетью безопасности для общества. Он удовлетворяет букве закона в ЕС, не решая при этом глобальную проблему дезинформации с помощью ИИ.
Сказка о двух корпоративных стратегиях
На рынке контраст между OpenAI и ее основным конкурентом, Anthropic, разителен. Anthropic представила свою собственную систему водяных знаков в начале этого года, но решила включить ее для всех пользователей по всему миру. OpenAI выбрала более избирательный путь, включив эту функцию по умолчанию только там, где того требует закон. Пользователи в США, Азии и других регионах по-прежнему будут получать «чистые» результаты, если они или их организации не включат функцию вручную через API.
Такое региональное разделение создает фрагментированную цифровую среду. Студент в Берлине будет получать эссе с водяными знаками по умолчанию, а студент в Нью-Йорке — нет. С точки зрения потребителя это говорит о том, что OpenAI рассматривает водяные знаки как регуляторный барьер, который нужно преодолеть, а не как фундаментальную характеристику надежного продукта. Компания делает необходимый минимум, чтобы оставаться в рамках закона в ЕС, сохраняя при этом свой продукт максимально удобным в других регионах.
| Характеристика | OpenAI textGrain | Anthropic Watermarking |
|---|---|---|
| Регион по умолчанию | Только ЕС | Глобально |
| Точность обнаружения | 92% (Идеал) | Высокая (Проприетарная) |
| Чувствительность к правкам | Высокая (20% правок ломают систему) | От умеренной до высокой |
| Доступ | Ограниченный круг исследователей | Публичный/API |
| Стандарт | Проприетарный | Проприетарный/C2PA |
Техническое препятствие: текст против изображений
Технически наносить водяные знаки на текст значительно сложнее, чем на изображения или видео. Когда система вроде DALL-E или Midjourney создает изображение, она может скрыть метаданные в пикселях или настроить паттерны шума так, что они останутся невидимыми для глаза, но очевидными для компьютера. Пиксели плотны и предлагают тысячи мест для скрытия сигнала.
Текст устроен иначе, потому что он дискретен. В предложении не так много слов, и у каждого слова есть ограниченное количество синонимов, имеющих смысл в контексте. Если ИИ вынужден выбирать конкретные слова для сохранения водяного знака, он рискует сделать текст неуклюжим или однообразным. OpenAI утверждает, что textGrain не снижает качества, но статистический компромисс присутствует всегда. Чтобы водяной знак оставался заметным, ИИ должен пожертвовать небольшой долей своей творческой случайности. Вот почему точность обнаружения еще ниже для коротких сообщений или переведенных текстов. В электронном письме из трех предложений просто недостаточно данных, чтобы скрыть сложный математический отпечаток.
Что это значит для вашей цифровой жизни
Обычному пользователю следует относиться к появлению textGrain со здоровым скептицизмом. Если вы учитель, редактор или менеджер по найму, вы не можете полагаться на эти детекторы для получения окончательного ответа. Систему слишком легко обмануть. Пользователь может взять результат из ChatGPT, прогнать его через другой ИИ без водяных знаков для быстрого перефразирования, и исходный след исчезнет.
В конечном счете, это системный сдвиг в том, как мы воспринимаем цифровые доказательства. Мы уходим от мира, где можем доверять увиденному, к миру, где нам нужен «ключ» для проверки подлинности. В настоящее время OpenAI держит этот ключ за «бархатным канатом», предоставляя доступ только ограниченному числу исследователей и организаций. Такая непрозрачность создает новый вид дисбаланса сил. Компания, создающая контент, является единственной, кто может надежно его распознать, и даже в этом случае — только если пользователь поленился внести правки.
Навигация в мире с водяными знаками
С практической точки зрения внедрение textGrain в ЕС — это бета-тестирование будущего, в котором весь цифровой труд будет помечен. Это напоминание о том, что инструменты, которые мы используем, все чаще подчиняются невидимому каркасу международного права. Хотя Закон ЕС об ИИ направлен на защиту граждан от дипфейков и автоматизированной пропаганды, доступные технические средства еще недостаточно устойчивы для достижения этой цели.
Потребителям стоит наблюдать за своими привычками по мере внедрения этих функций. Вы можете заметить тонкие изменения в том, как ChatGPT формулирует ответы, стараясь сохранить свой статистический отпечаток. Вы также можете увидеть рост популярности инструментов для «очистки ИИ» — простых программ, разработанных специально для того, чтобы переписывать текст ровно настолько, чтобы стереть эти маркеры. Игра в «кошки-мышки» между лабораториями ИИ и пользователями вступает в новую, более локализованную фазу.
Двигаясь вперед, перестаньте искать значок или штамп «Сделано ИИ». Эти маркеры становятся частью цифровой «сырой нефти», питающей наши приложения, скрытой глубоко в математике читаемых нами предложений. Суть в том, что никакой водяной знак не заменит критическое мышление. Независимо от того, есть ли в абзаце скрытое статистическое «зерно» или нет, ответственность за проверку фактов и намерений по-прежнему лежит на читателе. Цифровой стажер теперь помечает свою работу, но проверять, верна ли она, все равно придется начальнику.
Источники:
- OpenAI Technical Paper on textGrain and Statistical Watermarking
- European Commission: EU AI Act Regulatory Framework
- Anthropic Official Blog: Global Deployment of AI Content Marking
- C2PA (Coalition for Content Provenance and Authenticity) Standard Documentation



До встречи на другой стороне.
Наше решение для электронной почты и облачного хранения данных со сквозным шифрованием обеспечивает наиболее мощные средства безопасного обмена данными, гарантируя их сохранность и конфиденциальность.
/ Создать бесплатный аккаунт
