


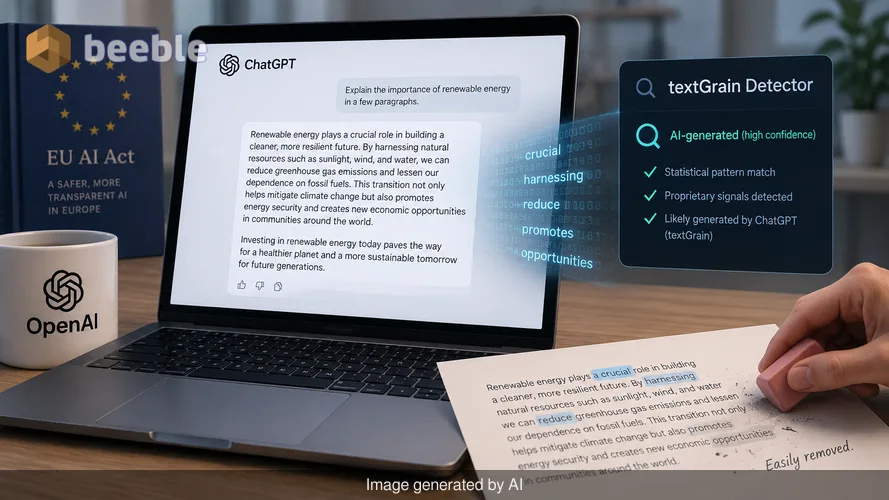
当世界要求明确区分人类与机器时,OpenAI 刚刚推出了一项承诺透明度但实际效果却非常脆弱的工具。该公司最近宣布,ChatGPT 现在将默认在欧盟范围内为其文本输出添加水印。这一变化是为了遵循《欧盟人工智能法案》(EU AI Act)的要求,该法案规定人工智能生成的内容必须是可检测的。然而,底层的现实表明,这种新的数字印记与其说是永久性的品牌标识,不如说更像是一个轻微的铅笔标记,孩子随手一抹就能擦掉。
OpenAI 将其新方法称为 textGrain。简单来说,这是一个专有系统,它在 AI 选择的词汇中嵌入了统计模式。对于普通用户来说,文本看起来与任何其他回复完全相同。语法没问题,语气一致,信息也一样。但对于专业的检测工具来说,这些词汇选择就像指纹一样。这个系统的运作方式就像一个不知疲倦的实习生,被告知在写备忘录时必须使用一组特定的同义词。如果你知道这个模式,你就能识别出这个实习生;如果你不知道,备忘录看起来就完全标准。
隐形模式的脆弱性
从大局来看,textGrain 的有效性完全取决于文本是否保持原样。OpenAI 自身的数据揭示了一个惊人的漏洞,而大多数公司新闻稿都倾向于掩盖这一点。在理想条件下,该工具在识别自家写作方面的成功率为 92%。这听起来令人印象深刻,直到你加入哪怕最微小的人为努力。
仅修改 10% 的生成文本,检测率就会骤降近 30%。如果用户更换 20% 的单词——也许只是更改几个形容词或改写几个句子——成功率会下降近 75%。从实际操作来看,任何掌握基本同义词词典的人都可以在几秒钟内绕过这个系统。这使得水印更像是监管机构的合规工具,而不是公众可靠的安全网。它满足了欧盟法律的字面要求,却未能真正解决人工智能欺骗这一核心问题。
两种企业战略的故事
在市场方面,OpenAI 与其主要竞争对手 Anthropic 之间的对比非常鲜明。Anthropic 在今年早些时候推出了自己的水印系统,但选择在全球范围内为所有用户启用。OpenAI 则采取了更具选择性的路径,仅在法律要求的地区默认开启该功能。美国、亚洲和其他地区的用户仍将获得“干净”的输出,除非他们或其组织通过 API 手动选择加入。
这种地域划分创造了一个碎片化的数字环境。柏林的学生默认会收到带水印的论文,而纽约的学生则不会。从消费者的角度来看,这表明 OpenAI 将水印视为需要跨越的监管障碍,而不是可信产品的基本功能。该公司正在做维持欧盟合法地位所需的最低限度工作,同时保持其产品在其他地区的无摩擦体验。
| 功能 | OpenAI textGrain | Anthropic 水印 |
|---|---|---|
| 默认地区 | 仅限欧盟 | 全球 |
| 检测率 | 92% (理想状态) | 高 (专有) |
| 编辑敏感度 | 高 (20% 修改即失效) | 中到高 |
| 访问权限 | 仅限研究人员 | 公开/API |
| 标准 | 专有 | 专有/C2PA |
文本对比图像的技术障碍
在底层技术上,为文本添加水印比为图像或视频添加水印要困难得多。当 DALL-E 或 Midjourney 等系统创建图像时,它可以将元数据隐藏在像素中,或以肉眼不可见但计算机显而易见的方式调整噪点模式。这些像素非常密集,提供了成千上万个隐藏信号的地方。
文本则不同,因为它是稀疏的。一个句子只有有限的单词,每个单词在上下文中只有有限数量的同义词是有意义的。如果 AI 为了维持水印而强行选择特定的词汇,就有可能让写作听起来笨拙或重复。OpenAI 声称 textGrain 不会降低质量,但统计上的权衡始终存在。为了保持水印的可检测性,AI 必须牺牲一小部分创作的随机性。这就是为什么短消息或翻译文本的检测率更低的原因。在只有三句话的电子邮件中,根本没有足够的数据来隐藏复杂的数学指纹。
这对你的数字生活意味着什么
对于日常用户来说,应该以审慎怀疑的态度看待 textGrain 的到来。如果你是老师、编辑或招聘经理,你不能依赖这些检测器来提供确定的答案。该系统太容易被破解了。用户可以获取 ChatGPT 的输出,通过另一个没有水印的 AI 进行快速改写,原始水印就会消失。
归根结底,这是我们看待数字证据的一种系统性转变。我们正从一个可以信任所见之物的世界,转向一个需要“密钥”来验证真实性的世界。OpenAI 目前将该密钥置于天鹅绒围栏之后,仅授权给少数研究人员和组织。这种不透明性创造了一种新的权力失衡。创建内容的公司也是唯一能可靠捕获内容的公司,即便如此,他们也只有在用户懒惰的情况下才能捕获。
应对带水印的世界
从实际角度来看,textGrain 在欧盟的推出是对未来所有数字劳动都被打上标签的一种 Beta 测试。它提醒我们,我们使用的工具正日益受到国际法律隐形骨架的约束。虽然《欧盟人工智能法案》旨在保护公民免受深度伪造和自动化宣传的误导,但目前可用的技术工具还不足以强大到实现这一目标。
随着这些功能的推出,消费者应该观察自己的习惯。你可能会注意到 ChatGPT 在尝试维持其统计指纹时,措辞发生了细微的变化。你可能还会看到“AI 清洗”工具的兴起——这些简单的程序专门设计用来改写文本,以剥离这些标记。AI 实验室与用户之间的猫鼠游戏正在进入一个新的、更局部化的阶段。
在我们前进的过程中,不要再寻找写着“由 AI 制造”的徽章或印章了。这些标记正成为驱动我们应用程序的数字原油的一部分,深藏在我们阅读的句子数学逻辑之中。底线是,任何水印都不能取代批判性思维。无论一段文字是否含有隐藏的统计颗粒,验证事实和意图的责任仍然落在读者身上。数字实习生现在正在给它的工作打标签,但检查工作是否正确仍然取决于老板。
资料来源:
- OpenAI Technical Paper on textGrain and Statistical Watermarking
- European Commission: EU AI Act Regulatory Framework
- Anthropic Official Blog: Global Deployment of AI Content Marking
- C2PA (Coalition for Content Provenance and Authenticity) Standard Documentation




