


Pourquoi le nouveau filigrane numérique d'OpenAI ne vous empêchera pas d'être trompé
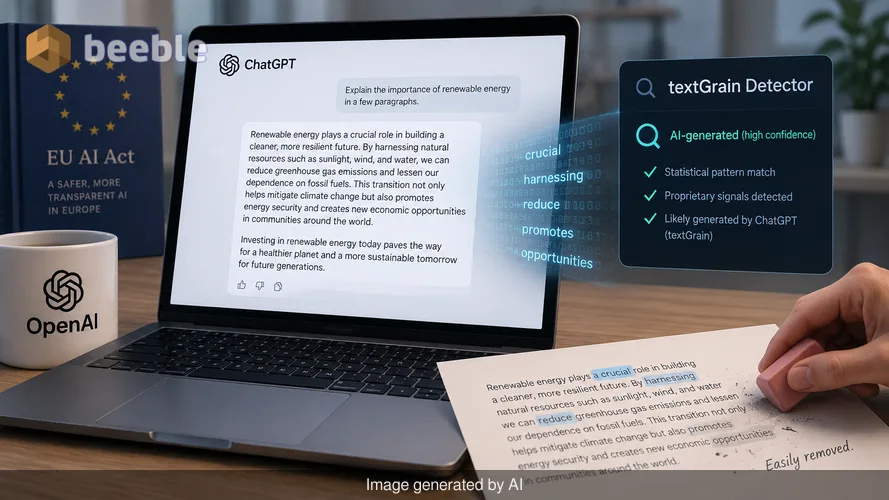
Alors que le monde exige de la clarté sur ce qui est humain et ce qui est machine, OpenAI vient de lancer un outil qui promet de la transparence mais livre quelque chose de bien plus fragile. L'entreprise a récemment annoncé que ChatGPT allait désormais apposer un filigrane sur ses sorties textuelles par défaut pour les utilisateurs de l'Union européenne. Ce changement fait suite aux exigences de la loi sur l'IA de l'UE (EU AI Act), qui impose que le contenu généré par IA soit détectable. Cependant, la réalité technique suggère que ce nouveau sceau numérique ressemble moins à une marque permanente qu'à un trait de crayon léger qu'un enfant pourrait effacer d'un simple geste.
OpenAI appelle sa nouvelle méthode textGrain. En termes simples, il s'agit d'un système propriétaire qui intègre des modèles statistiques dans les mots choisis par l'IA. Pour l'utilisateur moyen, le texte semble identique à n'importe quelle autre réponse. La grammaire est correcte, le ton est cohérent et l'information est la même. Mais pour un outil de détection spécialisé, ces choix de mots agissent comme une empreinte digitale. Ce système fonctionne comme un stagiaire infatigable à qui l'on aurait demandé d'utiliser un ensemble spécifique de synonymes chaque fois qu'il rédige une note. Si vous connaissez le modèle, vous pouvez identifier le stagiaire. Si vous ne le connaissez pas, la note semble parfaitement standard.
La fragilité des modèles invisibles
Si l'on regarde la situation dans son ensemble, l'efficacité de textGrain dépend entièrement du fait que le texte reste intact. Les propres données d'OpenAI révèlent une vulnérabilité surprenante que la plupart des communiqués de presse d'entreprise préféreraient passer sous silence. Dans des conditions idéales, l'outil a un taux de réussite de 92 % pour identifier sa propre écriture. Cela semble impressionnant jusqu'à ce que vous appliquiez le moindre effort humain.
Modifier seulement 10 % du texte généré fait chuter le taux de détection de près de 30 %. Si un utilisateur remplace 20 % des mots — peut-être en changeant quelques adjectifs ou en reformulant quelques phrases — le taux de réussite chute de près de 75 %. Concrètement, n'importe qui ayant une connaissance de base d'un dictionnaire de synonymes peut contourner ce système en quelques secondes. Cela fait du filigrane un outil de conformité pour les régulateurs plutôt qu'un filet de sécurité fiable pour le public. Il satisfait à la lettre de la loi dans l'UE sans réellement résoudre le problème global de la tromperie par l'IA.
L'histoire de deux stratégies d'entreprise
Du côté du marché, le contraste entre OpenAI et son principal concurrent, Anthropic, est frappant. Anthropic a introduit son propre système de filigrane plus tôt cette année, mais a choisi de l'activer pour tous les utilisateurs à l'échelle mondiale. OpenAI a pris une voie plus sélective, n'activant la fonctionnalité par défaut que là où la loi l'exige. Les utilisateurs aux États-Unis, en Asie et dans d'autres régions recevront toujours des résultats « propres », à moins qu'eux-mêmes ou leurs organisations ne choisissent manuellement de l'activer via une API.
Cette division régionale crée un environnement numérique fragmenté. Un étudiant à Berlin recevra par défaut des dissertations filigranées, tandis qu'un étudiant à New York n'en recevra pas. Du point de vue du consommateur, cela suggère qu'OpenAI considère le filigrane comme un obstacle réglementaire à franchir plutôt que comme une caractéristique fondamentale d'un produit digne de confiance. L'entreprise fait le strict minimum pour rester légale dans l'UE tout en gardant son produit aussi fluide que possible ailleurs.
| Caractéristique | OpenAI textGrain | Filigrane Anthropic |
|---|---|---|
| Région par défaut | UE uniquement | Mondiale |
| Taux de détection | 92 % (Idéal) | Élevé (Propriétaire) |
| Sensibilité à l'édition | Élevée (20 % de changement le brise) | Modérée à élevée |
| Accès | Chercheurs limités | Public/API |
| Norme | Propriétaire | Propriétaire/C2PA |
L'obstacle technique du texte par rapport aux images
Sous le capot, le filigranage du texte est nettement plus difficile que celui des images ou de la vidéo. Lorsqu'un système comme DALL-E ou Midjourney crée une image, il peut cacher des métadonnées dans les pixels ou ajuster les modèles de bruit de manière à ce qu'ils restent invisibles à l'œil nu mais évidents pour un ordinateur. Ces pixels sont denses et offrent des milliers d'endroits pour cacher un signal.
Le texte est différent car il est épars. Une phrase ne contient qu'un certain nombre de mots, et chaque mot possède un nombre limité de synonymes qui ont du sens dans le contexte. Si l'IA impose un choix de mots spécifique pour maintenir le filigrane, elle risque de rendre l'écriture lourde ou répétitive. OpenAI affirme que textGrain ne réduit pas la qualité, mais le compromis statistique est toujours présent. Pour garder le filigrane détectable, l'IA doit sacrifier une petite partie de son originalité créative. C'est pourquoi le taux de détection est encore plus bas pour les messages courts ou les textes traduits. Il n'y a tout simplement pas assez de données dans un e-mail de trois phrases pour cacher une empreinte mathématique complexe.
Ce que cela signifie pour votre vie numérique
Pour l'utilisateur quotidien, l'arrivée de textGrain doit être accueillie avec un scepticisme sain. Si vous êtes un enseignant, un éditeur ou un responsable du recrutement, vous ne pouvez pas vous fier à ces détecteurs pour obtenir une réponse définitive. Le système est trop facile à manipuler. Un utilisateur peut prendre une sortie de ChatGPT, la passer par une autre IA non filigranée pour une réécriture rapide, et le filigrane original disparaîtra.
En fin de compte, il s'agit d'un changement systémique dans notre façon de percevoir la preuve numérique. Nous nous éloignons d'un monde où nous pouvons faire confiance à ce que nous voyons pour aller vers un monde où nous avons besoin d'une « clé » pour vérifier l'authenticité. OpenAI garde actuellement cette clé derrière un cordon de velours, n'accordant l'accès qu'à un nombre limité de chercheurs et d'organisations. Cette opacité crée un nouveau type de déséquilibre de pouvoir. L'entreprise qui crée le contenu est aussi la seule à pouvoir le détecter de manière fiable, et même dans ce cas, elle ne peut le détecter que si l'utilisateur est paresseux.
Naviguer dans un monde filigrané
Concrètement, le déploiement de textGrain dans l'UE est un test bêta pour un futur où tout travail numérique sera étiqueté. Cela rappelle que les outils que nous utilisons sont de plus en plus soumis à la colonne vertébrale invisible du droit international. Bien que la loi sur l'IA de l'UE vise à protéger les citoyens contre les deepfakes et la propagande automatisée, les outils techniques disponibles ne sont pas encore assez résilients pour atteindre cet objectif.
Les consommateurs devraient observer leurs propres habitudes à mesure que ces fonctionnalités sont déployées. Vous pourriez remarquer des changements subtils dans la façon dont ChatGPT formule ses réponses alors que le modèle tente de maintenir son empreinte statistique. Vous pourriez également voir une augmentation des outils de « nettoyage d'IA » — des programmes simples conçus spécifiquement pour réécrire le texte juste assez pour supprimer ces marqueurs. Le jeu du chat et de la souris entre les laboratoires d'IA et les utilisateurs entre dans une nouvelle phase, plus localisée.
À mesure que nous avançons, cessez de chercher un badge ou un tampon indiquant « Fabriqué par l'IA ». Ces marqueurs deviennent une partie du pétrole brut numérique qui alimente nos applications, cachés au plus profond des mathématiques des phrases que nous lisons. L'essentiel est qu'aucun filigrane ne peut remplacer la pensée critique. Qu'un paragraphe possède ou non un grain statistique caché, la responsabilité de vérifier les faits et l'intention incombe toujours au lecteur. Le stagiaire numérique étiquette désormais son travail, mais c'est toujours au patron de vérifier si le travail est réellement correct.
Sources :
- OpenAI Technical Paper on textGrain and Statistical Watermarking
- European Commission: EU AI Act Regulatory Framework
- Anthropic Official Blog: Global Deployment of AI Content Marking
- C2PA (Coalition for Content Provenance and Authenticity) Standard Documentation



On se retrouve de l'autre côté.
Notre solution de messagerie cryptée de bout en bout et de stockage en nuage constitue le moyen le plus puissant d'échanger des données en toute sécurité, garantissant ainsi la sûreté et la confidentialité de vos données.
/ Créer un compte gratuit
