


Por qué la nueva marca de agua digital de OpenAI no evitará que te engañen
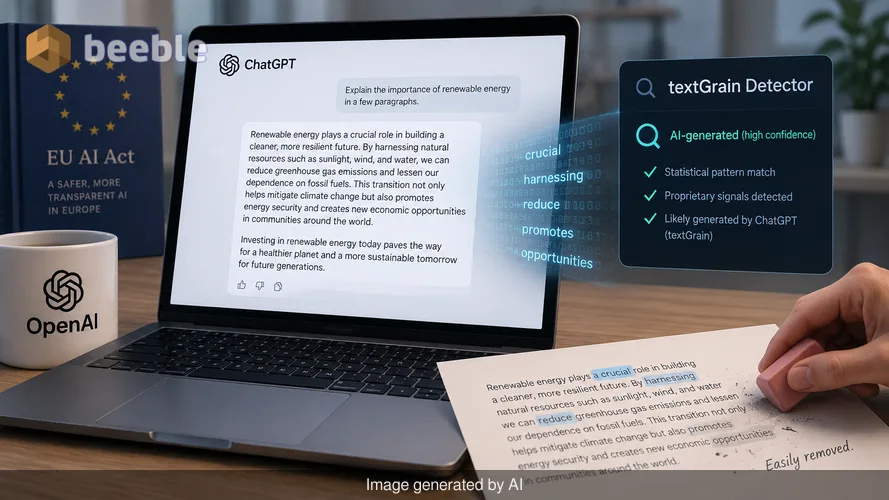
Mientras el mundo exige claridad sobre qué es humano y qué es máquina, OpenAI acaba de lanzar una herramienta que promete transparencia pero entrega algo mucho más frágil. La empresa anunció recientemente que ChatGPT ahora pondrá marcas de agua en sus salidas de texto por defecto para los usuarios de la Unión Europea. Este cambio responde a los requisitos de la Ley de IA de la UE, que exige que el contenido generado por IA sea detectable. Sin embargo, la realidad bajo el capó sugiere que este nuevo sello digital se parece menos a una marca permanente y más a un trazo ligero de lápiz que un niño podría borrar con un solo movimiento.
OpenAI llama a su nuevo método textGrain. En términos sencillos, se trata de un sistema patentado que incrusta patrones estadísticos en las palabras que elige la IA. Para el usuario medio, el texto parece idéntico a cualquier otra respuesta. La gramática es correcta, el tono es consistente y la información es la misma. Pero para una herramienta de detección especializada, esas elecciones de palabras actúan como una huella dactilar. Este sistema funciona como un pasante incansable al que se le ha ordenado usar un conjunto específico de sinónimos cada vez que escribe un memorando. Si conoces el patrón, puedes identificar al pasante. Si no conoces el patrón, el memorando parece perfectamente estándar.
La fragilidad de los patrones invisibles
Mirando el panorama general, la eficacia de textGrain depende enteramente de que el texto permanezca intacto. Los propios datos de OpenAI revelan una vulnerabilidad sorprendente que la mayoría de los comunicados de prensa corporativos preferirían pasar por alto. En condiciones ideales, la herramienta tiene una tasa de éxito del 92 por ciento en la identificación de su propia escritura. Esto suena impresionante hasta que se aplica la más mínima cantidad de esfuerzo humano.
Cambiar solo el 10 por ciento del texto generado hace que la tasa de detección caiga en picado casi un 30 por ciento. Si un usuario intercambia el 20 por ciento de las palabras —quizás cambiando algunos adjetivos o reformulando un par de oraciones— la tasa de éxito cae casi un 75 por ciento. En la práctica, cualquier persona con un conocimiento básico de un diccionario de sinónimos puede eludir este sistema en segundos. Esto convierte a la marca de agua en una herramienta de cumplimiento para los reguladores en lugar de una red de seguridad fiable para el público. Satisface la letra de la ley en la UE sin resolver realmente el problema general del engaño de la IA.
Una historia de dos estrategias corporativas
En el lado del mercado, el contraste entre OpenAI y su principal competidor, Anthropic, es marcado. Anthropic introdujo su propio sistema de marcado de agua a principios de este año, pero optó por habilitarlo para todos los usuarios a nivel mundial. OpenAI ha tomado un camino más selectivo, activando la función por defecto solo donde la ley lo exige. Los usuarios en los Estados Unidos, Asia y otras regiones seguirán teniendo resultados "limpios" a menos que ellos o sus organizaciones opten manualmente por participar a través de una API.
Esta división regional crea un entorno digital fragmentado. Un estudiante en Berlín recibirá ensayos con marca de agua por defecto, mientras que un estudiante en Nueva York no. Desde el punto de vista del consumidor, esto sugiere que OpenAI ve el marcado de agua como un obstáculo regulatorio que superar en lugar de una característica fundamental de un producto confiable. La empresa está haciendo lo mínimo indispensable para seguir siendo legal en la UE mientras mantiene su producto con la menor fricción posible en otros lugares.
| Característica | OpenAI textGrain | Marcado de agua de Anthropic |
|---|---|---|
| Región por defecto | Solo UE | Global |
| Tasa de detección | 92% (Ideal) | Alta (Propietaria) |
| Sensibilidad a la edición | Alta (20% de cambio lo rompe) | Moderada a Alta |
| Acceso | Investigadores limitados | Público/API |
| Estándar | Propietario | Propietario/C2PA |
El obstáculo técnico del texto frente a las imágenes
Bajo el capó, poner marcas de agua al texto es significativamente más difícil que a las imágenes o al vídeo. Cuando un sistema como DALL-E o Midjourney crea una imagen, puede ocultar metadatos en los píxeles o ajustar los patrones de ruido de una manera que permanece invisible al ojo pero obvia para una computadora. Estos píxeles son densos y ofrecen miles de lugares para ocultar una señal.
El texto es diferente porque es disperso. Una oración solo tiene un número determinado de palabras, y cada palabra tiene un número limitado de sinónimos que tienen sentido en el contexto. Si la IA fuerza una elección de palabras específica para mantener la marca de agua, corre el riesgo de que la escritura suene torpe o repetitiva. OpenAI afirma que textGrain no reduce la calidad, pero el compromiso estadístico siempre está presente. Para mantener la marca de agua detectable, la IA debe sacrificar una pequeña cantidad de su aleatoriedad creativa. Esta es la razón por la que la tasa de detección es aún más baja para mensajes cortos o texto traducido. Simplemente no hay suficientes datos en un correo electrónico de tres oraciones para ocultar una huella matemática compleja.
Qué significa esto para tu vida digital
Para el usuario cotidiano, la llegada de textGrain debe recibirse con un sano escepticismo. Si eres profesor, editor o gerente de contratación, no puedes confiar en estos detectores para obtener una respuesta definitiva. El sistema es demasiado fácil de manipular. Un usuario puede tomar un resultado de ChatGPT, pasarlo por una IA diferente sin marca de agua para una reescritura rápida, y la marca de agua original desaparecerá.
En última instancia, este es un cambio sistémico en la forma en que vemos la prueba digital. Nos estamos alejando de un mundo donde podemos confiar en lo que vemos y hacia un mundo donde necesitamos una "llave" para verificar la autenticidad. OpenAI mantiene actualmente esa llave detrás de una cuerda de terciopelo, otorgando acceso solo a un número limitado de investigadores y organizaciones. Esta opacidad crea un nuevo tipo de desequilibrio de poder. La empresa que crea el contenido es también la única que puede detectarlo de manera confiable, e incluso entonces, solo pueden detectarlo si el usuario es perezoso.
Navegando en un mundo con marcas de agua
En términos prácticos, el despliegue de textGrain en la UE es una prueba beta para un futuro donde todo el trabajo digital esté etiquetado. Sirve como recordatorio de que las herramientas que utilizamos están cada vez más sujetas a la columna vertebral invisible de la ley internacional. Si bien la Ley de IA de la UE tiene como objetivo proteger a los ciudadanos de ser engañados por deepfakes y propaganda automatizada, las herramientas técnicas disponibles aún no son lo suficientemente resistentes para cumplir ese objetivo.
Los consumidores deben observar sus propios hábitos a medida que se implementan estas funciones. Es posible que notes cambios sutiles en la forma en que ChatGPT redacta sus respuestas mientras el modelo intenta mantener su huella estadística. También podrías ver un aumento en las herramientas de "limpieza de IA", programas simples diseñados específicamente para reescribir texto lo suficiente como para eliminar estos marcadores. El juego del gato y el ratón entre los laboratorios de IA y los usuarios está entrando en una fase nueva y más localizada.
A medida que avanzamos, deja de buscar una insignia o un sello que diga "Hecho por IA". Estos marcadores se están convirtiendo en parte del petróleo crudo digital que impulsa nuestras aplicaciones, ocultos en lo profundo de las matemáticas de las oraciones que leemos. La conclusión es que ninguna marca de agua puede reemplazar el pensamiento crítico. Ya sea que un párrafo tenga un grano estadístico oculto o no, la responsabilidad de verificar los hechos y la intención sigue recayendo en el lector. El pasante digital ahora está etiquetando su trabajo, pero todavía le corresponde al jefe verificar si el trabajo es realmente correcto.
Fuentes:
- OpenAI Technical Paper on textGrain and Statistical Watermarking
- European Commission: EU AI Act Regulatory Framework
- Anthropic Official Blog: Global Deployment of AI Content Marking
- C2PA (Coalition for Content Provenance and Authenticity) Standard Documentation



Nos vemos en el otro lado.
Nuestra solución de correo electrónico cifrado y almacenamiento en la nube de extremo a extremo proporciona los medios más potentes para el intercambio seguro de datos, lo que garantiza la seguridad y la privacidad de sus datos.
/ Crear una cuenta gratuita
