


Google offre spiccioli per le parole che alimentano la sua ricerca basata sull'IA
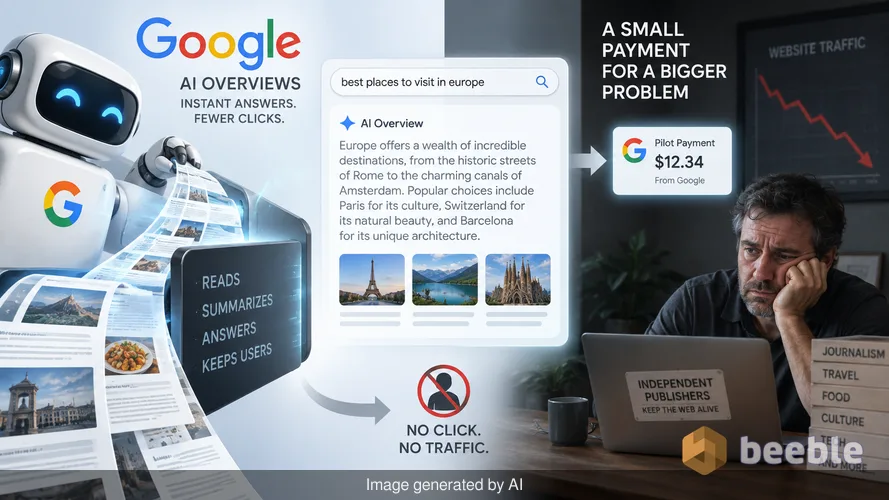
Mentre Google presenta il suo nuovo programma di pagamento come un ponte verso una nuova era della ricerca, la realtà è un divario sempre più ampio tra ciò che l'azienda prende e ciò che restituisce. Il colosso delle ricerche sta attualmente testando un sistema per pagare i siti web quando i loro contenuti alimentano la sua intelligenza artificiale, ma i primi dati suggeriscono che questi pagamenti sono poco più che spiccioli per l'editore medio. Questo programma pilota, che comprende circa 100 partecipanti, rappresenta il tentativo di Google di riparare un rapporto che l'IA ha effettivamente interrotto.
Storicamente, l'accordo tra Google e il web era semplice. Google inviava i suoi bot automatizzati a leggere il tuo sito e, in cambio, inviava utenti alle tue pagine. Questo traffico si trasformava in entrate pubblicitarie o vendite. Le Panoramiche dell'IA (AI Overviews) hanno cambiato questa dinamica. Ora, l'IA legge il tuo sito, scrive un riassunto e fornisce la risposta direttamente all'utente. L'utente non clicca mai. Il traffico scompare. Per evitare che gli editori blocchino i suoi bot, Google ha iniziato a offrire pagamenti diretti. Tuttavia, l'entità di questi pagamenti è così esigua che molti editori si chiedono se il web aperto possa sopravvivere in questo nuovo ecosistema.
La matematica dietro il frullatore digitale
Pensa a Gemini, l'IA di Google, come a un frullatore digitale ad alta velocità. Prende migliaia di articoli da diverse fonti, li polverizza e ne versa una purea omogenea di informazioni. L'utente ne ottiene un rapido assaggio, ma i singoli sapori — gli scrittori e i ricercatori originali — si perdono nel mix. Secondo un rapporto di The Information, il compenso finanziario per questo processo è deludente. Molti editori di medie dimensioni nel programma pilota vedono pagamenti che equivalgono a circa un decimo dell'uno per cento delle loro consuete entrate pubblicitarie.
Per un sito web che guadagna 1 milione di dollari all'anno dalla pubblicità, un pagamento dello 0,1% da parte di Google ammonta a soli 1.000 dollari. Questo non è un sostituto per il traffico perso. È un errore di arrotondamento. Queste cifre minuscole hanno spinto diverse grandi società di media a rifiutare interamente il programma pilota. Queste aziende ritengono che, restandone fuori, possano mantenere il potere contrattuale per un accordo più realistico. Sostengono che se Google ha bisogno dei loro dati per rendere utile la sua IA, Google deve pagare un prezzo che rifletta il costo di produzione di quei dati.
Un programma pilota con pagamenti minimi
Google ha ammesso circa 100 editori in questo gruppo sperimentale. I criteri per definire cosa costituisca un contributo materiale a una risposta dell'IA rimangono opachi. Gli editori riferiscono che i loro guadagni mensili sono imprevedibili, rendendo impossibile pianificare il budget per il futuro. Un partecipante della prima ora è sulla buona strada per guadagnare oltre 1 milione di dollari all'anno, il che rappresenta una vittoria significativa per il suo specifico modello di business. Tuttavia, questa sembra essere una rara eccezione piuttosto che la regola.
Più comune è l'esperienza di una nuova aggiunta al pilota che ha guadagnato tra i 50.000 e i 60.000 dollari. Anche se sembra una somma decente, è solo una piccola fetta dei guadagni totali di quell'azienda. I siti più piccoli vedono meno di 1.000 dollari nell'arco di diversi mesi. Ciò è particolarmente preoccupante perché questi sono proprio i siti più vulnerabili ai cali di traffico. Se un blog di nicchia perde il 30% dei suoi visitatori a causa di un riassunto dell'IA ma ottiene solo 200 dollari di compensazione, la matematica semplicemente non funziona per la sopravvivenza a lungo termine.
Perché alcuni siti guadagnano più di altri
Curiosamente, la struttura dei pagamenti sembra favorire nicchie specifiche. Gli editori nel test hanno notato che gli argomenti con un forte interesse di nicchia ma meno concorrenza generale guadagnano di più. I siti di gaming e anime hanno visto risultati migliori rispetto ai media di informazione generale. Ciò è probabilmente dovuto al fatto che l'IA richiede dati specializzati e fattuali per rispondere a domande specifiche sulle meccaniche di gioco o sulle storie dei personaggi. L'informazione generale è una commodity; se un sito non fornisce il meteo o un aggiornamento politico, altri mille lo faranno.
Dietro il gergo dei punteggi di contributo e del peso algoritmico, il problema è la trasparenza. Gli editori utilizzano uno strumento chiamato Search Console per monitorare le proprie prestazioni, ma i dati forniti per i contributi dell'IA sono confusi. Non esiste un modo chiaro per vedere quale articolo specifico abbia innescato un pagamento o come Google calcoli il valore di un singolo paragrafo. Senza questa trasparenza, il programma sembra meno una partnership e più una donazione.
Il motore di ricerca che non molla la presa
L'obiettivo di Google è organizzare le informazioni del mondo, ma quelle informazioni non sono una risorsa naturale. Sono un prodotto creato da persone che devono pagare l'affitto. Se i siti web smettono di pubblicare perché non possono permetterselo, l'IA alla fine non avrà nulla di nuovo da imparare. Ecco perché l'attuale tensione è così sistemica. Alcuni editori stanno già portando la battaglia in tribunale. Una coalizione di editori di libri ha fatto causa per l'uso di materiale protetto da copyright nei modelli di addestramento. Penske Media, che possiede Variety e Rolling Stone, ha fatto causa a Google per la perdita di traffico.
Penske Media sostiene che l'attuale sistema di Google sia ingiusto perché lega lo scraping dell'IA alla ricerca web standard. In pratica, se un sito web vuole apparire nei risultati di ricerca organica di Google, deve permettere a Google di scansionare i suoi contenuti per l'addestramento dell'IA. Non c'è una via di mezzo. Questo approccio "tutto o niente" costringe gli editori a scegliere tra perdere il loro traffico tradizionale o regalare i loro contenuti all'IA che alla fine sostituirà quel traffico. Guardando il quadro generale, si tratta di una transizione forzata che favorisce la piattaforma rispetto al creatore.
I regolatori globali stanno perdendo la pazienza
Le agenzie governative stanno iniziando a esaminare questi accordi sull'IA. Il governo del Regno Unito ha recentemente ordinato a Google di fornire un'opzione di opt-out per lo scraping dell'IA che non penalizzi il posizionamento di un sito nei risultati di ricerca regolari. Si tratta di un cambiamento fondamentale. Se gli editori possono dire di no all'IA pur rimanendo nell'indice di ricerca, Google dovrà offrire pagamenti molto più alti per ottenere i dati di cui ha bisogno.
La Commissione Europea sta inoltre conducendo un'indagine antitrust. Vogliono determinare se Google stia compensando equamente gli editori o se stia usando la sua posizione dominante sul mercato per sottopagare i contenuti. Storicamente, Google ha avuto difficoltà nei casi antitrust dell'UE, che spesso sono sfociati in multe multimiliardarie. Se i regolatori decideranno che questi pagamenti dello 0,1% sono predatori, Google potrebbe essere costretta a rivedere l'intera struttura dei pagamenti a livello globale.
Cosa significa questo per la tua ricerca quotidiana
Per l'utente medio, questa battaglia potrebbe sembrare una disputa aziendale, ma influisce direttamente sulla qualità delle informazioni che trovi online. Se l'attuale modello di pagamento rimane così basso, vedremo due grandi cambiamenti nel panorama digitale. In primo luogo, più siti web passeranno ai paywall. Se Google non pagherà per i contenuti, dovranno farlo i lettori. Troverai meno articoli gratuiti e più richieste di abbonamento.
In secondo luogo, la varietà delle informazioni si ridurrà. Il giornalismo di alta qualità è costoso. Se il ritorno finanziario per un'indagine approfondita è di pochi centesimi da un riassunto dell'IA, gli editori smetteranno di fare quel lavoro. Passeranno a contenuti di riempimento economici generati dall'IA per inseguire quei pochi spiccioli disponibili. Internet potrebbe diventare un ciclo di feedback di riassunti di bassa qualità, dove i fatti originali verificati dagli esseri umani sono sempre più rari. In definitiva, l'informazione "gratuita" fornita dall'IA ha un costo nascosto, e quel costo è la salute delle fonti su cui facciamo affidamento ogni giorno.
Come consumatore, presta attenzione alle fonti citate nei tuoi riassunti dell'IA. Se trovi un sito che fornisce costantemente le risposte di cui hai bisogno, visitalo direttamente. Il rapporto tra motori di ricerca e creatori sta cambiando, e le tue abitudini di clic sono uno dei pochi modi tangibili per sostenere gli editori che mantengono internet utile.
Fonti:
The Information, Reuters, UK Competition and Markets Authority, European Commission Antitrust Reports, Penske Media Corporate Statements.



Ci vediamo dall'altra parte.
La nostra soluzione di archiviazione e-mail crittografata end-to-end fornisce i mezzi più potenti per lo scambio sicuro dei dati, garantendo la sicurezza e la privacy dei tuoi dati.
/ Creare un account gratuito
